
Na svetovnem spletu je obseg besedil, ki jih ustvari umetna inteligenca, po navedbah RTV Slovenija že presegel obseg besedil, ki jih napiše človek. To po mnenju strokovnjakov odpira resno vprašanje, kaj se zgodi, ko se veliki jezikovni modeli začnejo učiti na besedilih, ki so jih sami proizvedli.
Kot opozarjajo, takšno krožno učenje vodi v vse bolj enolične in podobne izide. Model, ki ga treniramo na njegovih lastnih izdelkih, sčasoma izgublja raznolikost in kakovost, dokler ne pride do pojava, ki ga opisujejo kot kolaps – umetna inteligenca se po njihovih besedah »zaduši« od lastnih izdelkov.
Primerjava, ki so jo uporabili, je nazorna: veliki jezikovni modeli naj bi bili v prihodnosti nekaj takega, kot je zlato v bankah. Gre za dragocen vir, ki pa ima svojo mejo – če vanj ves čas dodajamo le predelano različico njega samega, njegova vrednost in uporabnost upadata.
Za slovenski prostor je opozorilo še posebej pomembno, saj je količina kakovostnih besedil v slovenščini omejena. Če bo v prihodnje vse več spletnih vsebin v slovenščini nastajalo s pomočjo umetne inteligence, se lahko ta bazen še zoži, kar bi vplivalo na kakovost modelov, ki bi jih razvijali za slovenski jezik.
Strokovnjaki zato poudarjajo pomen sledljivosti virov in ohranjanja človeško napisanih besedil kot referenčnega gradiva. Brez tega se lahko zgodi, da bodo prihodnji modeli manj zanesljivi, njihovi izidi pa vse bolj podobni drug drugemu – kar bi dolgoročno škodilo tako razvoju tehnologije kot jezikovni raznolikosti.
Vir: RTV Slovenija
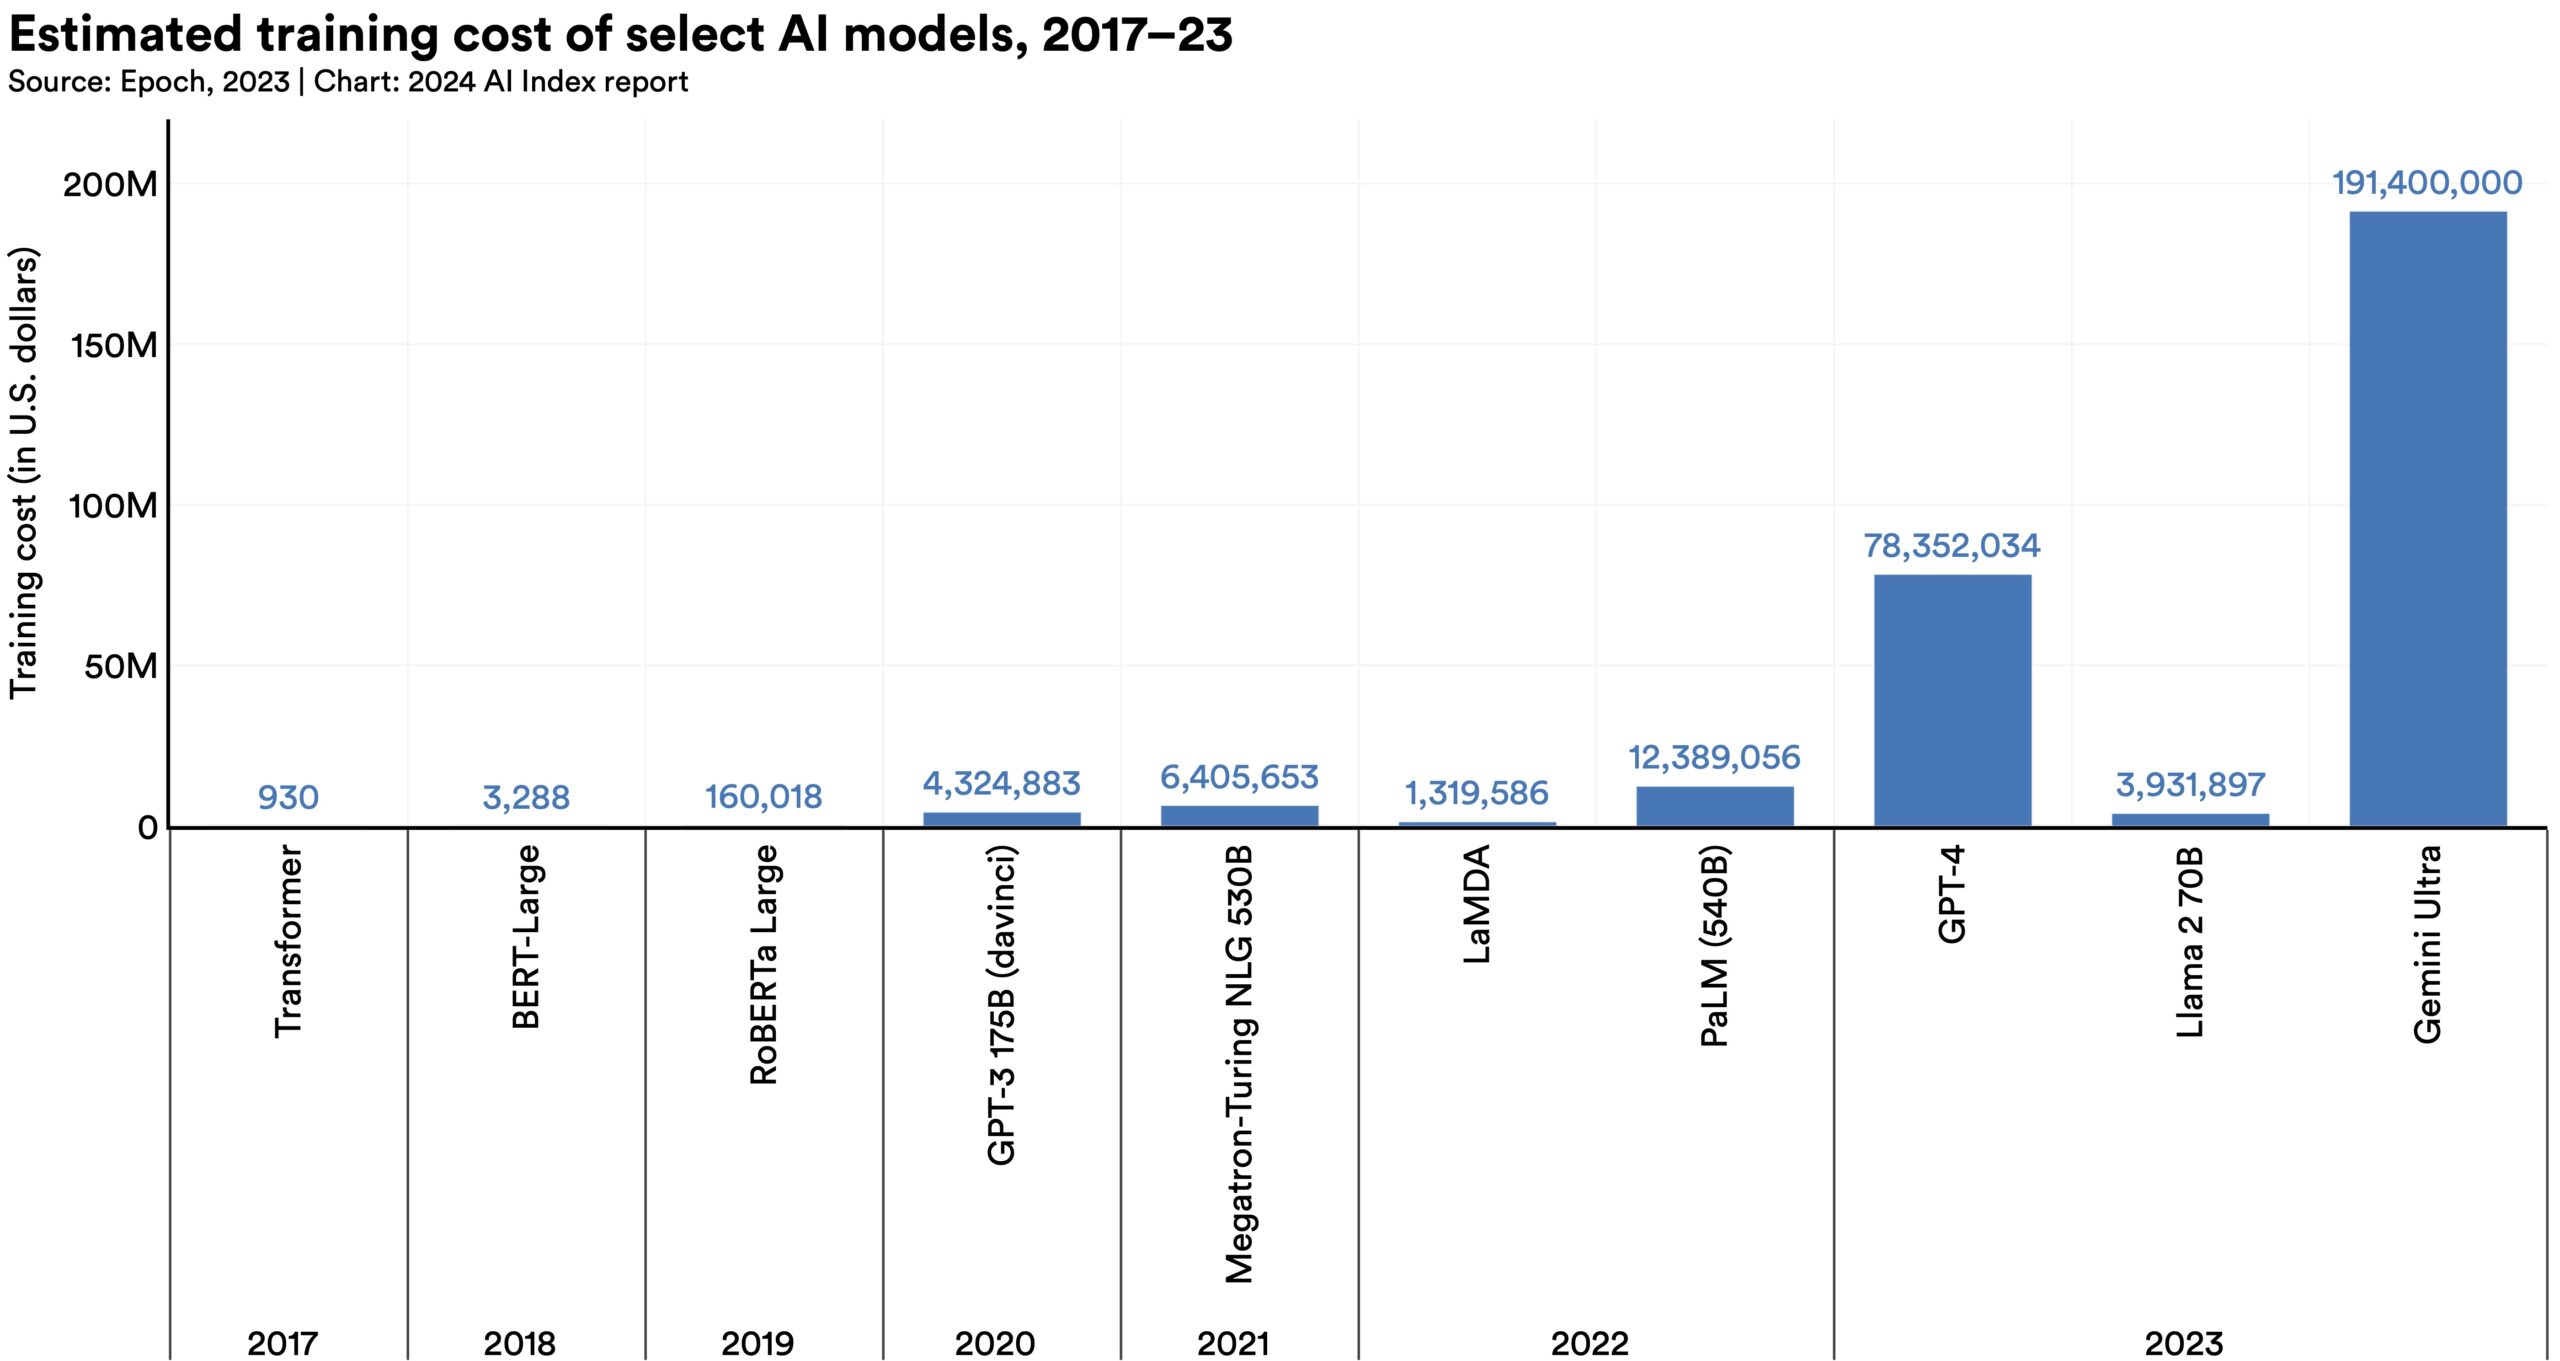
Foto: Stanford Institute for Human-Centered Artificial Intelligence (permission obtained by email from the AI index research manager) / BY-SA (vir slike)